一、背景
在Go的runtime包中封装了一个 mutux ,这个mutex被runtime包中大量组件使用,比如 channel、netpoll、检查活跃的定时器 等等。
**sync.Mutex和runtime.mutext区别:**简单说就是sync.Mutex是用户层的锁,Lock抢锁失败会造成goroutine阻塞(会调用gopark)。runtime.mutex 是给 runtime使用的锁,Lock抢锁失败,会造成m阻塞(线程阻塞,底层调用的futex)。
二、基础知识
2.1 Mutex
Mutex 全称是Mutual Exclusion ,俗称互斥体或者互斥锁。是一种用于多线程编程中,防止两条线程同时对同一公共资源(比如全局变量)进行读写的机制。
2.2 mmap 函数
mmap它的主要功能是将一个虚拟内存区域与一个磁盘上的文件关联起来,以初始化这个虚拟内存区域的内容,这个过程成为内存映射(memory mapping)。
直白一点说,就是可以将一个文件,映射到一段虚拟内存,写内存的时候操作系统会自动同步内存的内容到文件。内存同步到磁盘,还涉及到一个PageCache的概念,这里不去过度发散。
文件可以是磁盘上的一个实体文件,比如kafka写日志文件的时候,就用了mmap。
文件也可以是一个匿名文件,这种场景mmap不会去写磁盘,主要用于内存申请的场景。比如调用malloc函数申请内存,当申请的大小超过MMAP_THRESHOLD(默认是128K)大小,内核就会用mmap去申请内存。再比如TCMalloc算法也是通过mmap来申请一大块内存(匿名文件),然后切割内存,分配给程序使用。
网上很多资料一介绍mmap,就会说到zero copy,就是相对于标准IO来说少了一次内存Copy的开销。让大多数人忽略了mmap本质的功能,认为mmap=zero copy,mmap本质功能还是读写数据。

2.3 Futex
Futex是Fast Userspace Mutexes的缩写。是一个在Linux上实现锁定和构建高级抽象锁如信号量和POSIX互斥的基本工具。
Futex由一块能够被多个进程共享的内存空间(一个对齐后的整型变量)组成;这个整型变量的值能够通过汇编语言调用CPU提供的原子操作指令来增加或减少,并且一个进程可以等待直到那个值变成正数。Futex的操作几乎全部在用户空间完成;只有当操作结果不一致从而需要仲裁时,才需要进入操作系统内核空间执行。这种机制允许使用Futex的锁定原语有非常高的执行效率:由于绝大多数的操作并不需要在多个进程之间进行仲裁,所以绝大多数操作都可以在应用程序空间执行,而不需要使用(相对高代价的)内核系统调用。
futex的基本思想是竞争态总是很少发生的,只有在竞争态才需要进入内核,否则在用户态即可完成。futex的两个目标是:
- 尽量避免系统调用;
- 避免不必要的上下文切换(导致的
TLB失效等)。
Futex总结
简单一句话总结就是:futex基于mmap来映射一段内存记录锁的状态,使用mmap有两个好处,1)支持跨进程同步锁状态。2)用户态和内核态可以共用一块内存(zero copy也是说的这个),这样在用户态可以直接修改锁状态不用切换到内核态。futex加锁和解锁,都是先通过CAS(这个CPU支持的指令CMPXCHGQ,不需要系统调用)尝试设置状态,如果设置成功了,就正常返回,如果CAS失败,就会进行系统调用(切换到内核)。
伪代码如下:
/*
val 0: unlock
val 1: lock, no waiters
val 2: lock , one or more waiters
*/
int val = 0;
void lock()
{
    int c
    if ((c = cmpxchg(val, 0, 1)) != 0) {
        if (c != 2)
            c = xchg(val, 2);
        while (c != 0) {
            futex_wait((&val, 2); // 系统调用
            c = xchg(val, 2);
        }
    }
}

void unlock()
{
    if (atomic_dec(val) != 1){
    	val = 0;
       	futex_wake(&val, 1); // 系统调用
    }
}

//uaddr指向一个地址,val代表这个地址期待的值,当*uaddr==val时,才会进行wait(阻塞线程)
int futex_wait(int *uaddr, int val);
//唤醒n个在uaddr指向的锁变量上挂起等待的进程
int futex_wake(int *uaddr, int n);
Sync.Mutex和runtime.mutex也有类似的操作,一般都会有fastpath和slowpath,fastpath就是先尝试自旋n次CAS方式加锁,CAS成功就立即返回,否则就返回。
2.4 procyield 功能
实现代码如下:
TEXT runtime·procyield(SB),NOSPLIT,$0-0
	MOVL	cycles+0(FP), AX
again:
	PAUSE
	SUBL	$1, AX
	JNZ	again
	RET
由上面代码可以知道,就是执行n次PAUSE指令,n是函数调用传入的参数。
PAUSE指令的功能。查了下 X86 指令集 - PAUSE,主要是提高自旋的性能。
2.5 osyield
实现代码如下:
#define SYS_sched_yield 	24

TEXT runtime·osyield(SB),NOSPLIT,$0
	MOVL	$SYS_sched_yield, AX
	SYSCALL
	RET
osyield主要做了个系统调用,AX = 24,查下 Linux System Call Table,可以知道是系统调用的sched_yield这个函数。看下 sched_yield 的描述,主要功能是:让当前线程放弃CPU执行权限,把线程移到队列尾部,让优先执行其他线程。跟runtime.Gosched有点类似。
2.6 futexsleep 和 futexwakeup
Go的futexsleep和futexwakeup就是对futex的封装,实现代码如下 :
// 如果 *addr == val { 当前线程进入sleep状态 } ;不会阻塞超过ns,ns<0表示永远休眠
futexsleep(addr *uint32, val uint32, ns int64)
//如果任何线程阻塞在addr上,则唤醒至少cnt个阻塞的任务
futexwakeup(addr *uint32, cnt uint32)
futex就是系统调用,具体实现:
// int64 futex(int32 *uaddr, int32 op, int32 val,
//	struct timespec *timeout, int32 *uaddr2, int32 val2);
TEXT runtime·futex(SB),NOSPLIT,$0
	MOVQ	addr+0(FP), DI
	MOVL	op+8(FP), SI
	MOVL	val+12(FP), DX
	MOVQ	ts+16(FP), R10
	MOVQ	addr2+24(FP), R8
	MOVL	val3+32(FP), R9
	MOVL	$SYS_futex, AX
	SYSCALL
	MOVL	AX, ret+40(FP)
	RET
三、runtime.mutex 源码分析
3.1 mutex 结构
runtime的 mutex 定义在runtime/runtime2.go中。定义如下:
type mutex struct {
	// Empty struct if lock ranking is disabled, otherwise includes the lock rank
	lockRankStruct
	// Futex-based impl treats it as uint32 key,
	// while sema-based impl as M* waitm.
	// Used to be a union, but unions break precise GC.
	key uintptr
}
lockRankStruct这个是给runtime做死锁检测用的,只有设置了GOEXPERIMENT=staticlockranking才lockRankStruct才会有具体实现,否则的话这个结构体只会是个空Struct,空的Struct只要不是最后一个字段是不会占用任何空间的(详见final-zero-size-field),具体lockrank的CR,可以看这个提交。lookrank主要通过加锁顺序 来判断是否会死锁,如果加锁顺序不符合预期就会throw异常(注意这个不是panic不能被recover)。具体代码如下:
// checkRanks checks if goroutine g, which has mostly recently acquired a lock
// with rank 'prevRank', can now acquire a lock with rank 'rank'.
//
//go:systemstack
func checkRanks(gp *g, prevRank, rank lockRank) {
	rankOK := false
	if rank < prevRank {
		// If rank < prevRank, then we definitely have a rank error
		rankOK = false
	} else if rank == lockRankLeafRank {
		// If new lock is a leaf lock, then the preceding lock can
		// be anything except another leaf lock.
		rankOK = prevRank < lockRankLeafRank
	} else {
		// We've now verified the total lock ranking, but we
		// also enforce the partial ordering specified by
		// lockPartialOrder as well. Two locks with the same rank
		// can only be acquired at the same time if explicitly
		// listed in the lockPartialOrder table.
		list := lockPartialOrder[rank]
		for _, entry := range list {
			if entry == prevRank {
				rankOK = true
				break
			}
		}
	}
	if !rankOK {
		printlock()
		println(gp.m.procid, " ======")
		printHeldLocks(gp)
		throw("lock ordering problem")
	}
}
3.2 lock 实现
在macOS和Windows上runtime.mutex是基于pthread_mutex来实现的,详见 lock_sema。而在Linux上lock是基于futex来实现的,详见 lock_futex。这里我们只关注Linux下的实现。
func lock(l *mutex) {
    lockWithRank(l, getLockRank(l))
}

func lockWithRank(l *mutex, rank lockRank) {
    lock2(l)
}

func lock2(l *mutex) {
    gp := getg() // 获取当前的 goroutine

    if gp.m.locks < 0 {
        throw("runtime·lock: lock count")
    }
    gp.m.locks++ // g绑定的m的lock数量加1

	  // l.key 只有三种状态 mutex_unlocked、mutex_locked、mutex_sleeping
	  // mutex_unlocked 表示无锁状态
	  // mutex_locked 正常加锁状态
	  // mutex_sleeping 表示有线程调用futexsleep阻塞了
    // 设置状态为 mutex_locked ,注意这里是直接设置,不是CAS
    v := atomic.Xchg(key32(&l.key), mutex_locked)
    if v == mutex_unlocked { // 之前的状态是 mutex_unlocked 表示加锁成功了
        return
    }

	 // 走到这里,表示没有加锁成功
	 // 这里 v 不是 mutex_unlocked 所以只能是 MUTEX_LOCKED 或 MUTEX_SLEEPING
    // 所以 wait 可能是 MUTEX_LOCKED 或 MUTEX_SLEEPING
    // 如果我们将 l->key 从 MUTEX_SLEEPING 更改为其他值,我们必须小心在返回之前将其更改回 MUTEX_SLEEPING
    wait := v

    // 多核情况下尝试自旋4次,单个就不用自旋了
    spin := 0
    if ncpu > 1 {
        spin = active_spin // active_spin = 4
    }
    for {
        for i := 0; i < spin; i++ {
         	   // 注意我们上面设置了 l.key = mutex_locked
         	   // 这里如果 key = mutex_unlocked,表示肯定是其他持有锁的线程进行了锁的释放
            for l.key == mutex_unlocked {
            		// CAS 抢锁成功直接返回,否则再尝试自旋
                if atomic.Cas(key32(&l.key), mutex_unlocked, wait) {
                    return
                }
            }

            procyield(active_spin_cnt) // 执行 active_spin_cnt = 30 次 PAUSE指令
        }

        // passive_spin = 1 ,再尝试抢一次锁。
        for i := 0; i < passive_spin; i++ {
            for l.key == mutex_unlocked {
                if atomic.Cas(key32(&l.key), mutex_unlocked, wait) {
                    return
                }
            }
            osyield() // CAS 失败,系统调用`sched_yield`让出CPU
        }


        v = atomic.Xchg(key32(&l.key), mutex_sleeping)
        if v == mutex_unlocked {
        	   // 注意这里,如果是从 mutex_unlocked => mutex_sleeping 也认为是加锁成功,然后直接返回,不会走futexsleep阻塞当前线程。
        	   // 造成的影响就是,解锁的时候执行,执行 futexwakeup了,但是没有需要唤醒的线程(功能上应该没有影响)
            return
        }
        wait = mutex_sleeping // 设置 wait 状态为 mutex_sleeping 下次循环会设置为 mutex_sleeping 状态
        // l.key == mutex_sleeping 就 sleep,直到被唤醒。
        // 不然继续循环
        futexsleep(key32(&l.key), mutex_sleeping, -1)
    }
}

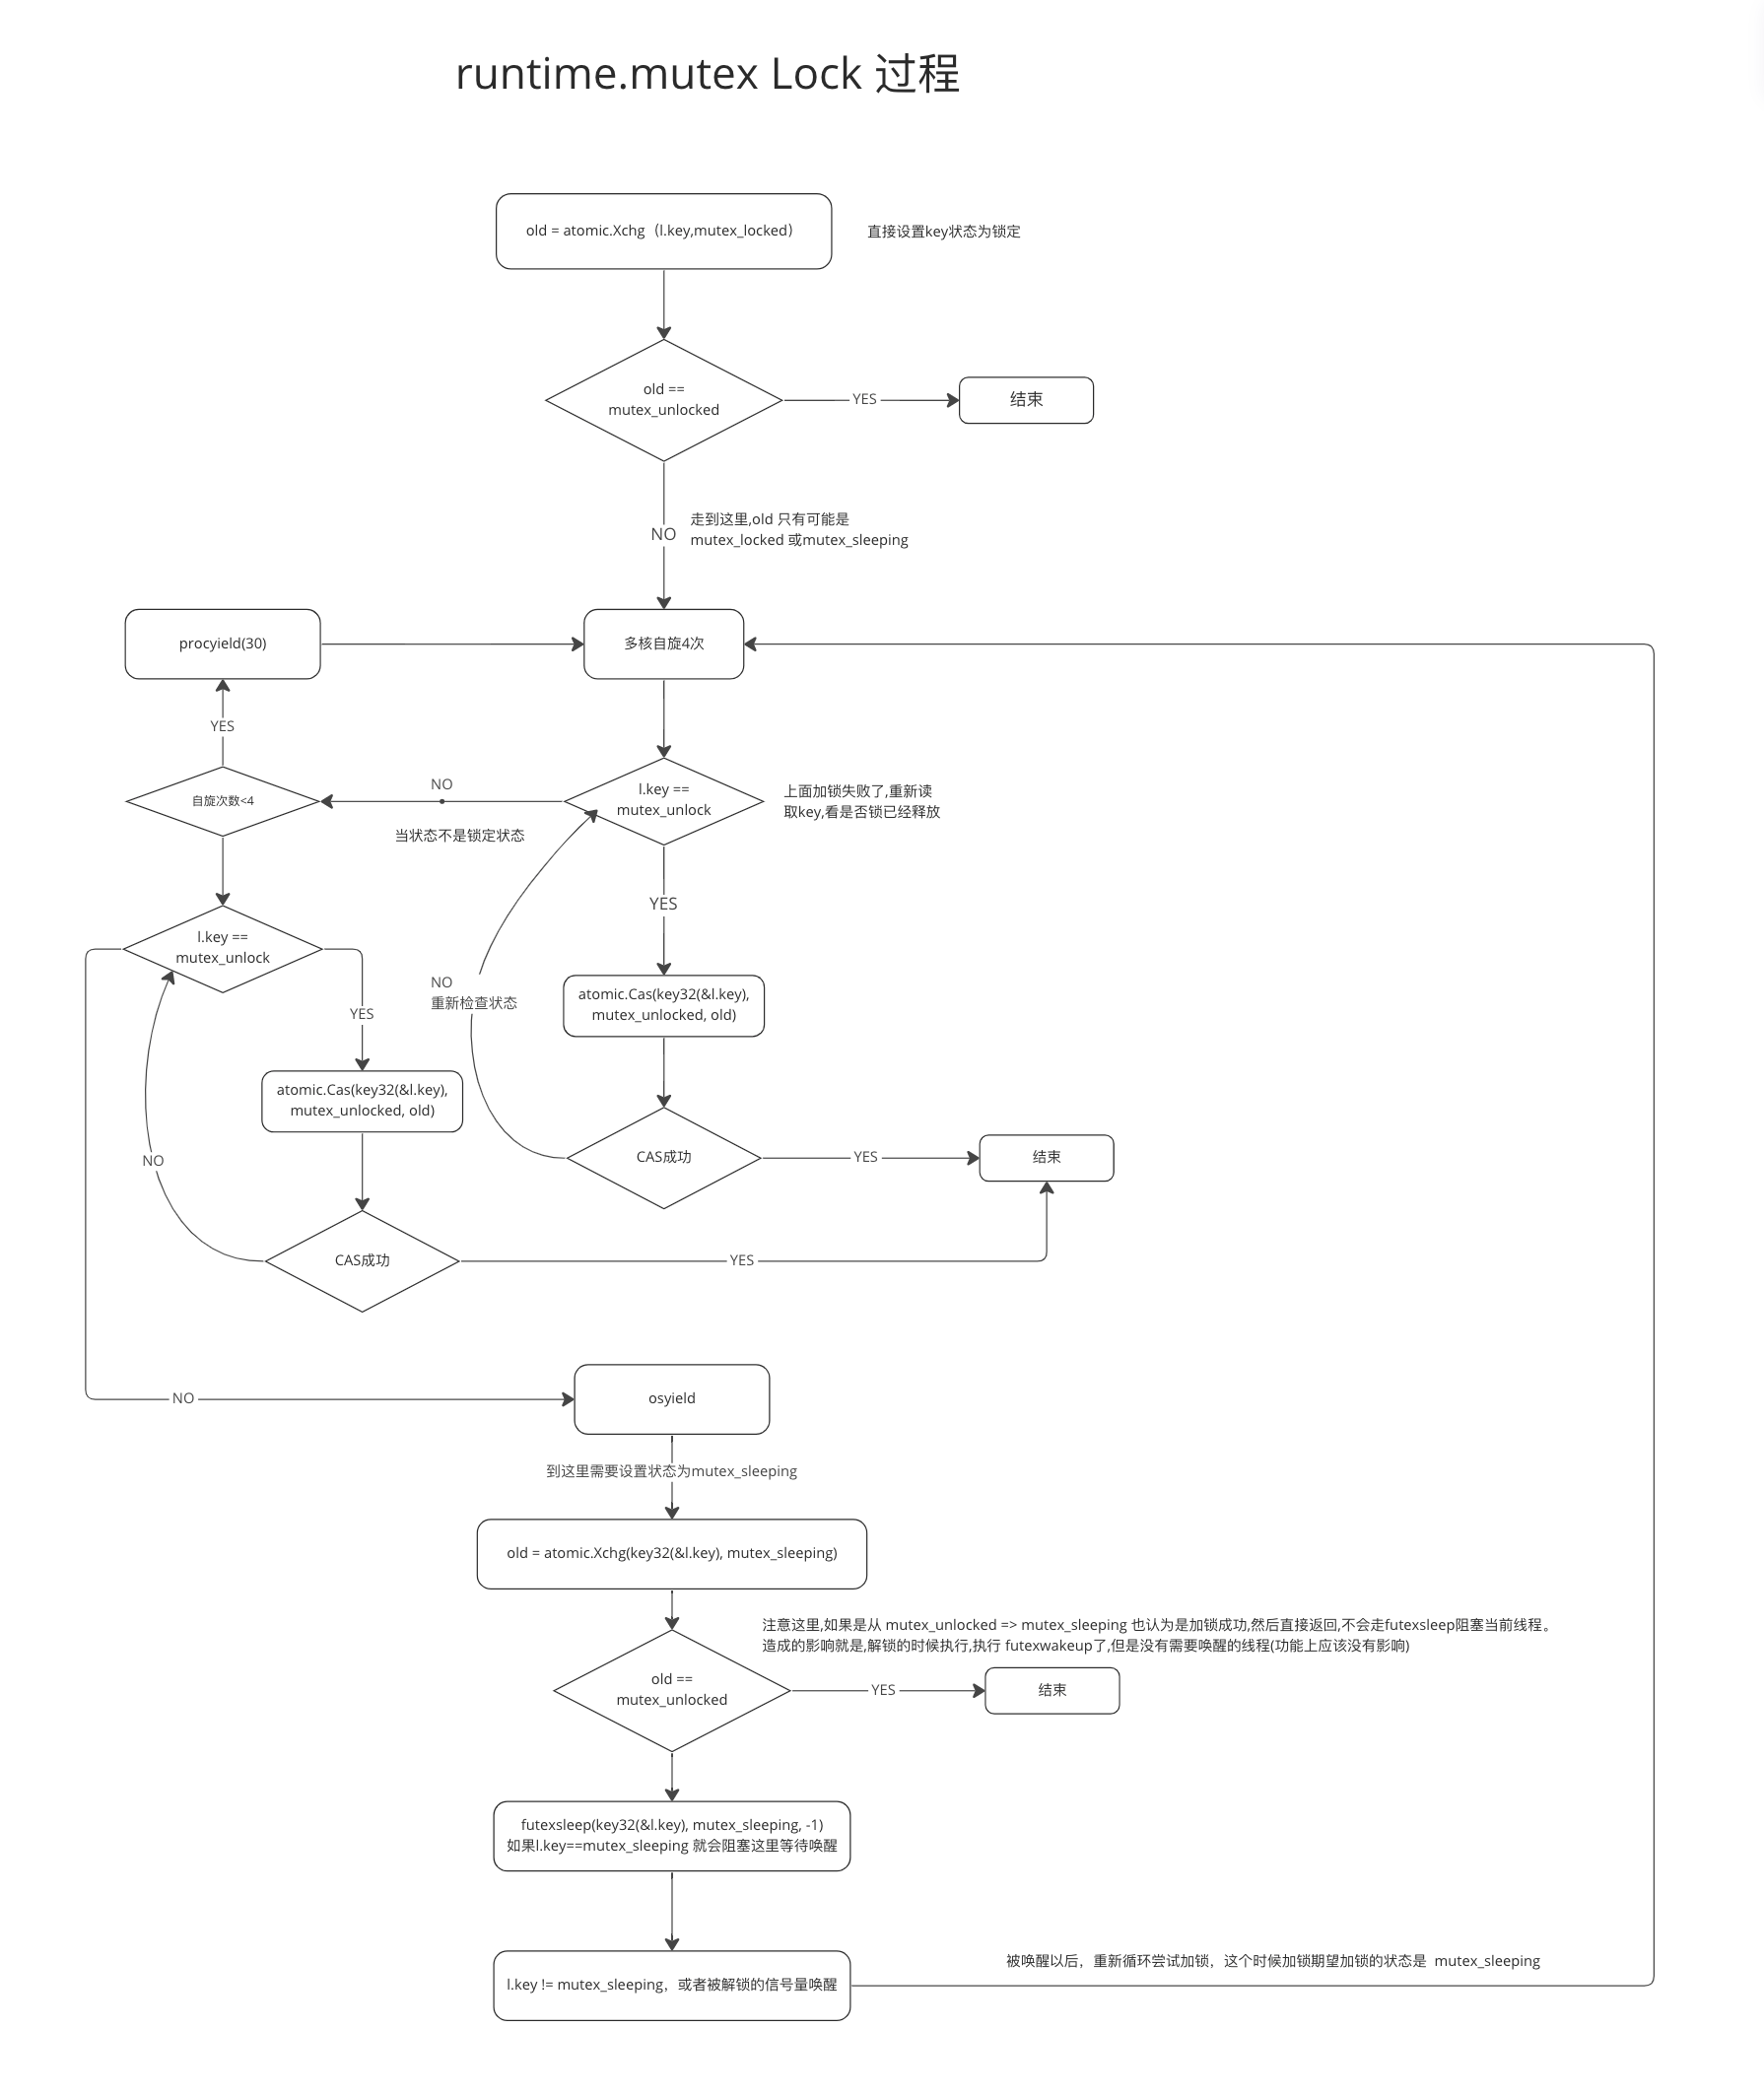
lock主要步骤如下:
- 调用
atomic.Xchg直接设置key的状态为mutex_locked(注意这里不是CAS,是直接设置)。 - 根据
atomic.Xchg返回的状态v,来判断是否加锁成功了,如果v = mutex_unlocked表示加锁成功了(这个时候可以直接返回了)。否则就是加锁失败,这个时候v可能是MUTEX_LOCKED或者MUTEX_SLEEPING的状态。 - 如果是多核的话,会尝试自旋
4,把l.key从状态mutex_unlocked改成wait。注意,我们在步骤1里面直接设置了key为mutex_locked,如果这里l.key = mutex_unlocked,只能说明是其他持有锁的线程释放了锁。这个CAS成功,表示加锁成功。如果加锁失败,会调用下procyield优化下自旋性能。 - 自旋
4次失败,会再尝试一次CAS,失败的话会调用osyield让出CPU。 osyield完成以后,继续执行,这个时候直接调用atomic.Xchg设置l.key = mutex_sleeping,表示当前准备调用futexsleep进行sleep。- 使用系统调用
futexsleep,如果l.key == mutex_sleeping,则当前线程进入失眠状态,直到有其他地方调用futexwakeup来唤醒。如果这个时候l.key != mutex_sleeping,说明在步骤5设置完这短短时间内,其他线程设置又重新设置了l.key状态比如设置为了mutex_locked或者mutex_unlocked。这个时候不会进入sleep,而是会去循环执行步骤1。
3.2 unlock 实现
func unlock(l *mutex) {
	unlockWithRank(l)
}

func unlockWithRank(l *mutex) {
	unlock2(l)
}

func unlock2(l *mutex) {
	// 设置 l.key = mutex_unlocked
	v := atomic.Xchg(key32(&l.key), mutex_unlocked)
	if v == mutex_unlocked {// 重复调用 unlock,直接抛出异常。
		throw("unlock of unlocked lock")
	}
	if v == mutex_sleeping { // 之前的状态是 mutex_sleeping,说明其他有线程在`sleep`,唤醒一个`sleep`的对象。
		futexwakeup(key32(&l.key), 1)
	}

	gp := getg()
	gp.m.locks--
	if gp.m.locks < 0 {
		throw("runtime·unlock: lock count")
	}
	if gp.m.locks == 0 && gp.preempt { // restore the preemption request in case we've cleared it in newstack
		gp.stackguard0 = stackPreempt
	}
}

unlock 实现总结:
- 调用
atomic.Xchg设置l.key = mutex_unlocked。 - 如果设置之前的状态就是
mutex_unlocked,直接抛异常程序退出。 - 如果之前状态是
mutex_sleeping,则唤醒一个阻塞在futexsleep的线程。 m的锁数量减一,如果锁数量等0且当前g是被抢占状态,要标记gp.stackguard0为stackPreempt,下次发生函数调用的时候,会主动让出这个g。
四、总结
runtime.mutex 主要是使用了CAS自旋配合procyield和osyield,最多尝试5次,自旋失败就使用futex系统调用来实现,整体代码逻辑比较简单易懂。